Desenvolvimento de Software • 7 min
Arquitetura de Microsserviços na Prática
Arquiteturas de microsserviços permitem que equipes de engenharia evoluam partes do sistema de forma independente, reduzindo o acoplamento entre módulos e acelerando o ritmo de entregas. Para uma software house, essa abordagem é o que possibilita atender clientes com necessidades muito diferentes sem multiplicar a complexidade de manutenção.
Mas a decisão de migrar de um monólito para microsserviços não pode ser tomada por modismo. Ela envolve trade-offs reais de complexidade operacional, observabilidade e cultura de times. Neste artigo, vou mostrar o que a pesquisa independente diz sobre arquiteturas desacopladas e como aplicar os princípios que realmente funcionam em produção.
Dado real: a pesquisa do DORA (DevOps Research and Assessment), que há mais de uma década estuda milhares de times, mostra que arquiteturas fracamente acopladas estão associadas a melhor desempenho de entrega e estabilidade. No relatório de 2019, times de elite faziam deploys 208 vezes mais frequentes e restauravam serviço 2.604 vezes mais rápido que os de baixo desempenho.
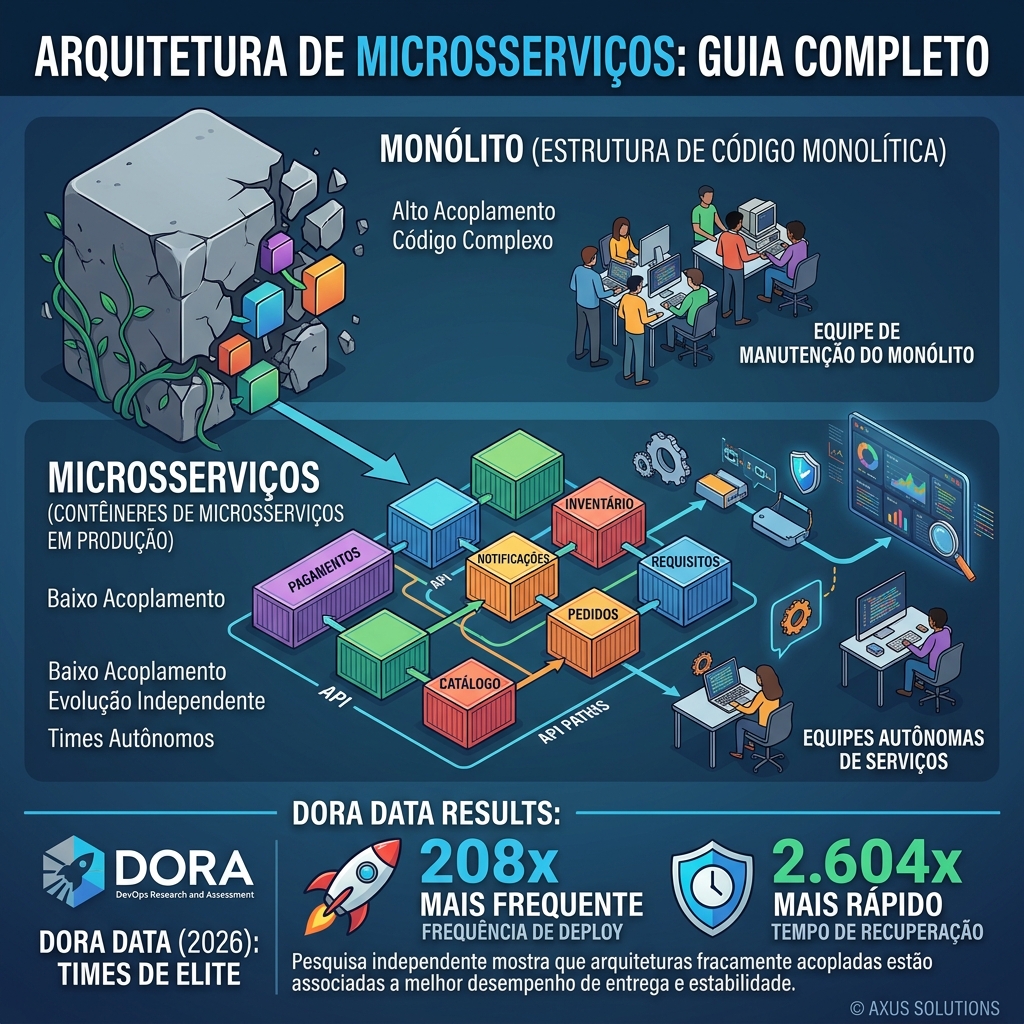
Monólito ou Microsserviços: Qual o Caminho Certo?
Nem todo produto precisa nascer como microsserviços. Sistemas pequenos ou times enxutos costumam se beneficiar de um monólito bem modularizado, migrando para serviços independentes apenas quando a complexidade e o volume de dados exigem escalabilidade granular.
A referência canônica sobre o tema, o microservices.io de Martin Fowler e James Lewis, define microsserviços como uma abordagem para desenvolver uma aplicação como um conjunto de pequenos serviços — cada um rodando em seu próprio processo e se comunicando por mecanismos leves, geralmente HTTP ou mensageria. O ponto central não é o tamanho do serviço, e sim a independência de deploy e de evolução.
O conselho prático que damos na Axus é: comece monolítico, mantenha as fronteiras de módulo bem definidas e só extraia serviços quando houver um motivo concreto — escala independente, time dedicado ou requisito de isolamento de falhas.
1. Comunicação Assíncrona entre Serviços
Filas de mensagens e eventos permitem que serviços se comuniquem sem depender da disponibilidade simultânea de todos os componentes, aumentando a resiliência do sistema como um todo. Quando um serviço falha, os eventos ficam retidos e são processados quando ele volta — em vez de a requisição inteira falhar.
Essa é a base das arquiteturas orientadas a eventos, que reduzem o acoplamento temporal entre produtores e consumidores. O trade-off é a complexidade adicional de garantir entrega, ordenação e idempotência — custos que precisam ser assumidos conscientemente.
Na prática, dois padrões ajudam a domar essa complexidade. O primeiro é a idempotência: consumidores devem ser capazes de processar a mesma mensagem mais de uma vez sem efeitos colaterais, porque sistemas de mensageria garantem "pelo menos uma vez" — e não "exatamente uma vez". O segundo é o padrão outbox: em vez de tentar publicar um evento na mesma transação que altera o banco de dados, o serviço grava o evento em uma tabela de saída e um processo separado o publica na fila. Isso evita o problema clássico de "evento publicado, mas transação revertida".
2. Observabilidade Distribuída
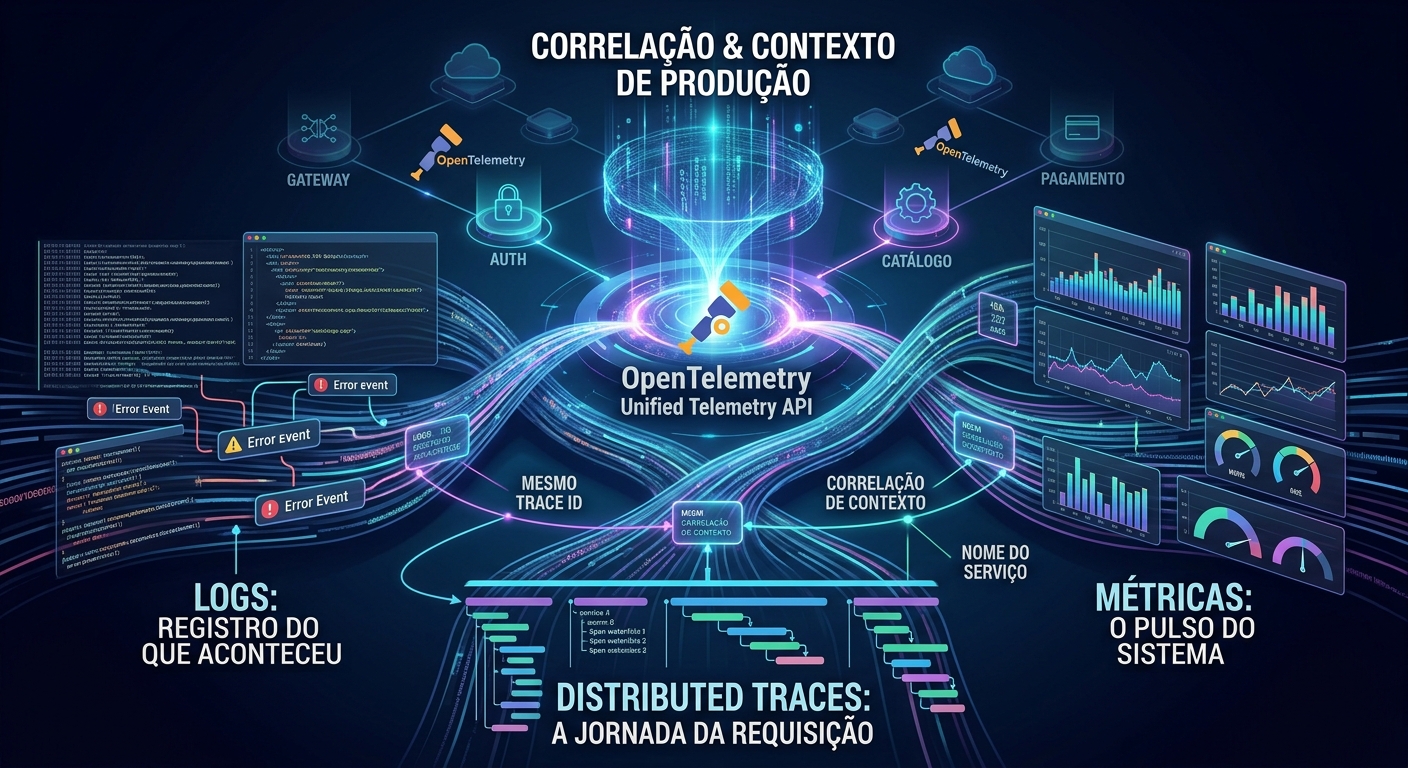
Rastreamento distribuído e logs centralizados são essenciais para entender o comportamento de um sistema composto por dezenas de serviços, permitindo identificar gargalos e falhas rapidamente. Sem observabilidade, cada incidente vira uma caça ao tesouro entre serviços.
O guia de re-arquitetura cloud-native do Google é explícito: muitos problemas de produção em sistemas distribuídos são emergentes, causados por interações entre múltiplos serviços. Por isso, investir em monitoramento, tracing e SLOs por serviço é pré-requisito — não um extra — para quem adota microsserviços.
3. Times Autônomos e Ownership Claro
Cada serviço deve ter um time responsável pelo seu ciclo de vida completo, do desenvolvimento ao monitoramento em produção, o que reduz dependências cruzadas e acelera decisões técnicas.
A pesquisa do DORA sobre times fracamente acoplados mostra que a capacidade de testar, fazer deploy e mudar um serviço de forma independente — sem depender de outros times — é o que de fato melhora a performance de entrega. Arquitetura e organização andam juntas: serviços independentes exigem times independentes.
Quando Não Usar Microsserviços
É tão importante saber quando adotar quanto saber quando evitar. Microsserviços são contraindicados quando o time é pequeno, o domínio de negócio é simples ou o produto ainda está em fase de discovery — nesses cenários, a sobrecarga operacional de operar múltiplos serviços consome exatamente o tempo que deveria ser investido em validar o produto.
O custo escondido não está no código, mas na operação: cada serviço adicional significa um pipeline de CI/CD, um conjunto de métricas, um processo de deploy e uma superfície de segurança a mais. Um time de cinco pessoas operando dez serviços gasta boa parte do sprint apenas mantendo a infraestrutura viva. O monólito modular — uma única aplicação com fronteiras de módulo bem definidas — oferece muitos dos benefícios de organização sem esse custo operacional.
Migração Incremental com o Padrão Strangler
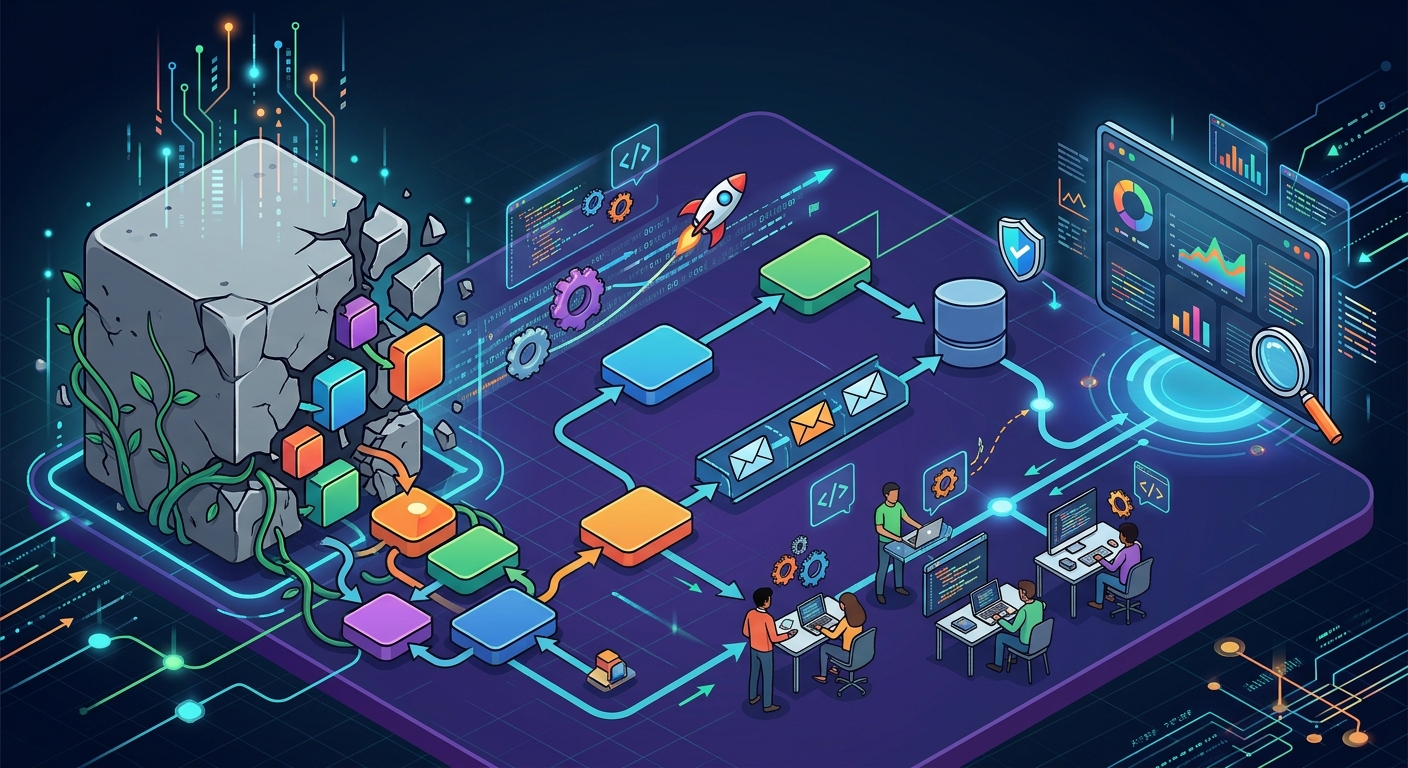
A migração de um monólito para microsserviços não precisa (nem deve) acontecer em um "big bang". O padrão conhecido como strangler fig propõe extrair funcionalidades uma a uma: cada novo recurso nasce como um serviço independente, enquanto o monólito continua atendendo o restante. Com o tempo, o monólito encolhe até restar apenas o núcleo que realmente faz sentido manter junto.
Essa abordagem reduz drasticamente o risco da migração. Cada extração é uma mudança pequena, testável e reversível — e o sistema inteiro permanece em produção funcionando durante todo o processo. É a diferença entre uma cirurgia de risco e uma série de pequenas intervenções.
Escalando com Responsabilidade
Microsserviços não resolvem problemas de arquitetura ruim — eles apenas distribuem esses problemas por toda a rede.
Adotar microsserviços exige maturidade em automação, observabilidade e cultura de times autônomos. Empresas que investem nesses pilares antes de migrar colhem os benefícios de escalabilidade sem herdar a complexidade operacional que costuma acompanhar essa transição.
Pilares de uma Migração Bem-Sucedida
Com base na pesquisa do DORA e na prática de mercado, estes são os pilares que sustentam uma migração segura:
- Automação de Deploy: pipelines de CI/CD por serviço reduzem o risco de cada nova versão em produção e permitem deploys frequentes e independentes.
- Observabilidade: métricas, logs e tracing distribuído tornam o sistema depurável e antecipam problemas antes de virarem incidentes.
- Contratos de API Estáveis: versionamento cuidadoso e testes de contrato evitam quebras entre serviços.
- Times Autônomos: ownership claro acelera decisões e reduz gargalos de coordenação entre equipes.
- Cultura de Testes: testes automatizados sustentam a confiança em deploys frequentes e em mudanças de grande escala.
Perguntas Frequentes
Microsserviços são sempre melhores que monólitos?
Não. A evidência do DORA aponta que o que importa é o desacoplamento — a capacidade de mudar e fazer deploy de forma independente — e não a quantidade de serviços. Para times pequenos e domínios simples, um monólito bem modularizado costuma ser a escolha mais eficiente.
Como saber se meu monólito está pronto para migrar?
Quando você identifica módulos com fronteiras claras, times dedicados e necessidades de escala independentes. Se o monólito ainda é um "blob" sem fronteiras definidas, migrar antes de organizar os módulos apenas transfere a bagunça para a rede.
Qual o maior erro em adoções de microsserviços?
Subestimar a complexidade operacional. Sem automação de deploy, observabilidade distribuída e times autônomos, a arquitetura de microsserviços se torna um passivo — mais incidentes, mais tempo de debugging e menos velocidade de entrega.
Conclusão
Microsserviços são uma ferramenta poderosa, mas não universal. A evidência do DORA é clara: o que importa é o desacoplamento — a capacidade de mudar, testar e fazer deploy de forma independente — e não a contagem de serviços. Times que constroem essa capacidade, com comunicação assíncrona, observabilidade distribuída e ownership claro, conseguem escalar com previsibilidade.
Na Axus Solutions, ajudamos empresas a decidir quando e como migrar para microsserviços, com foco em resultados mensuráveis e sem complexidade desnecessária. Se você está avaliando essa arquitetura para o seu produto, fale com nosso time de engenharia.