Cloud & DevOps • 7 min
Observabilidade: Enxergando o que Acontece em Produção
Você já passou a madrugada tentando descobrir por que uma requisição que funcionava ontem começou a falhar em produção? Em sistemas distribuídos, essa cena é mais comum do que parece — e quase sempre termina com alguém olhando logs desconexos, sem saber por onde começar. A boa notícia é que existe um caminho mais curto entre o sintoma e a causa: a observabilidade.
Neste artigo, vou mostrar como logs, métricas e tracing distribuído transformam incidentes complexos em problemas rastreáveis e resolvíveis. Se você é CTO, SRE ou tech lead, vai sair daqui com um roteiro prático para enxergar o que realmente acontece em produção — antes que o usuário perceba.
Dado real: o OpenTelemetry, o padrão aberto de telemetria que hoje sustenta a maioria das stacks de observabilidade, foi promovido ao nível Graduated da Cloud Native Computing Foundation (CNCF) em maio de 2026, com mais de 26 mil contribuidores no projeto. Ou seja: a observabilidade deixou de ser diferencial e virou infraestrutura essencial.
O que é observabilidade (e por que não é só monitoramento)
Observabilidade é a capacidade de entender o estado interno de um sistema a partir dos dados que ele emite para fora — sem precisar conhecer cada detalhe da sua implementação. Na prática, é a habilidade de fazer perguntas novas sobre um problema que você nunca viu antes e obter respostas rápidas.
O primer de observabilidade do OpenTelemetry resume bem: um sistema é observável quando você consegue resolver um incidente sem precisar adicionar mais instrumentação no meio da crise. Se o time precisa "chutar" ou adivinhar, a observabilidade está incompleta.
Monitoramento e observabilidade costumam ser confundidos, mas são coisas diferentes. Monitoramento responde "o que está quebrado agora?". Observabilidade responde "por que está quebrado?" — e permite explorar o desconhecido. A comparação entre observabilidade e monitoramento da Honeycomb explica essa distinção com clareza.
Na prática, a diferença aparece no dia a dia. Um sistema bem monitorado avisa quando a taxa de erros subiu. Um sistema observável permite que você descubra que a taxa de erros subiu apenas para usuários de um determinado plano, em uma região específica, após um deploy específico — e por quê. É essa profundidade que reduz drasticamente o tempo de investigação.
Os três pilares: logs, métricas e tracing distribuído
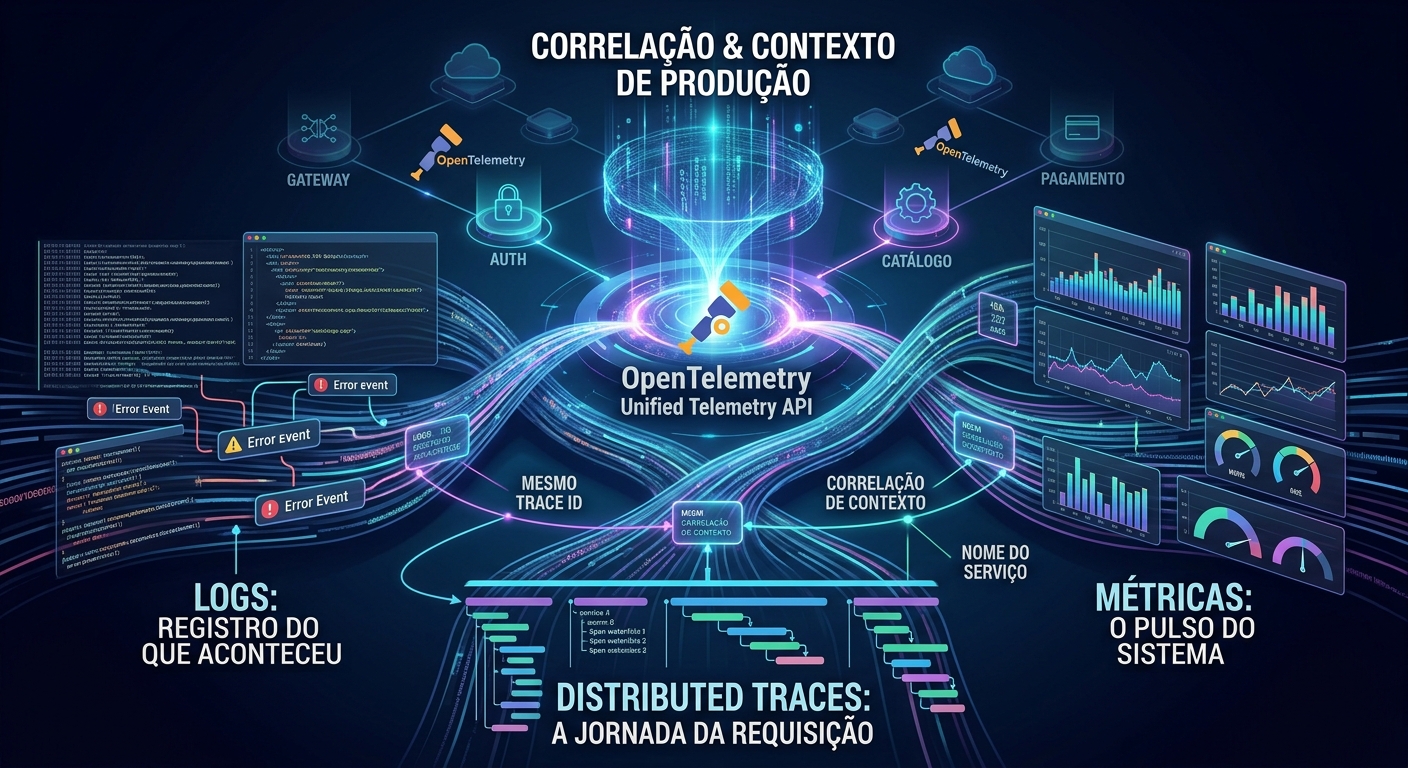
Para enxergar produção de verdade, você precisa de três tipos de sinal trabalhando juntos. Cada um responde a uma pergunta diferente, e o poder real aparece quando eles se complementam.
Logs: o registro do que aconteceu
Logs são mensagens com timestamp emitidas pelos serviços. São ótimos para entender eventos específicos, mas sozinhos costumam falhar: sem contexto de qual requisição gerou aquele erro, eles viram ruído. O valor real dos logs aparece quando eles são correlacionados a um trace ou a uma métrica — por exemplo, quando cada entrada de log carrega o mesmo trace ID da requisição que a gerou.
Métricas: o pulso do sistema
Métricas são agregações numéricas ao longo do tempo — taxa de erros, latência, uso de CPU, vazão de requisições. O Prometheus, projeto graduado da CNCF, é o padrão de facto para coletar e consultar métricas com a linguagem PromQL. Métricas são perfeitas para alertar e acompanhar tendências, mas não contam a história completa de uma requisição individual.
Uma métrica diz que a latência média subiu. Ela não diz qual requisição específica ficou lenta, nem em qual serviço o tempo foi gasto. Para isso, você precisa do terceiro pilar.
Tracing distribuído: a jornada da requisição
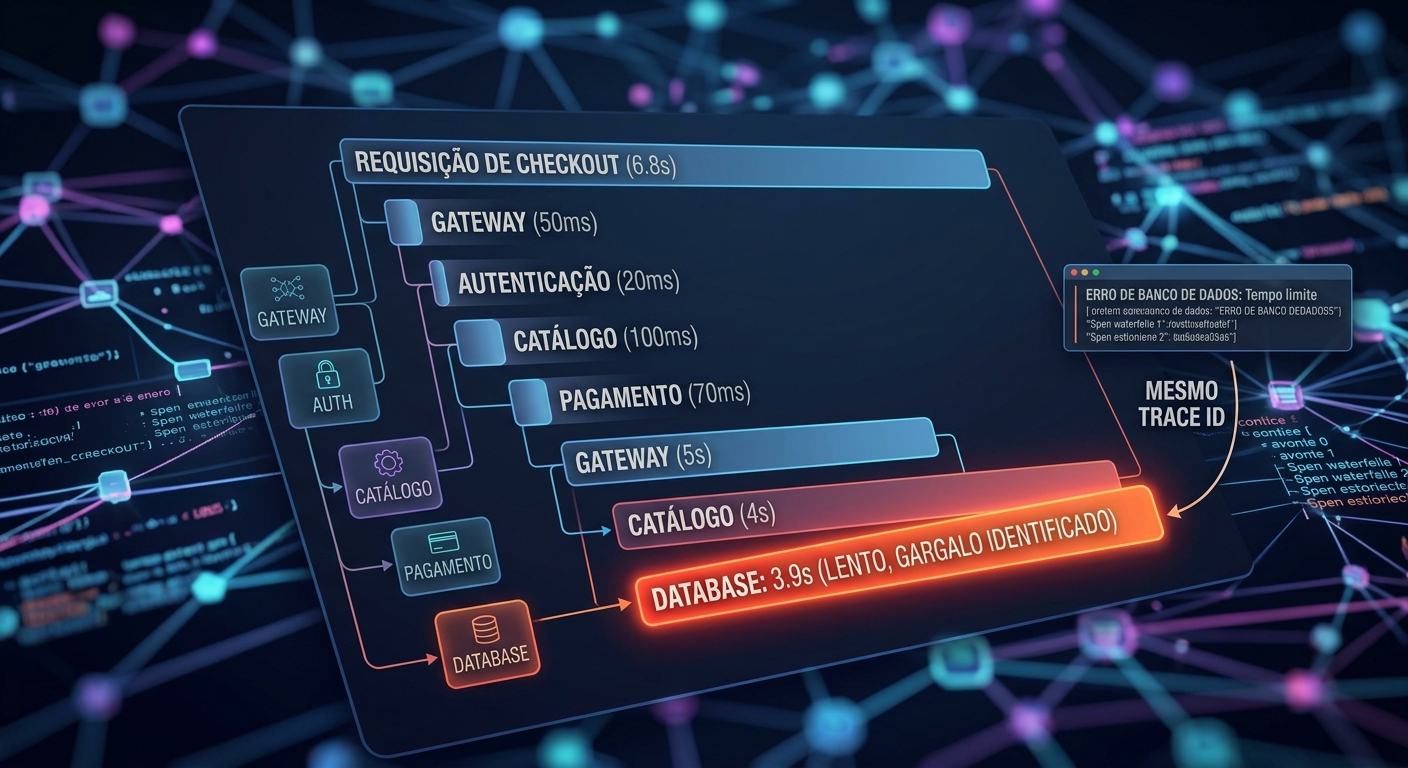
Tracing distribuído rastreia uma requisição enquanto ela atravessa vários serviços — do gateway ao banco de dados. Cada etapa vira um span, e o conjunto forma um trace que mostra exatamente onde o tempo foi gasto e onde algo falhou. É a peça que conecta logs e métricas ao contexto de cada usuário.
Esses três sinais são o que o OpenTelemetry chama de telemetria: os dados que o seu sistema emite para ser compreendido de fora.
Por que tracing distribuído muda o jogo em incidentes
Em uma arquitetura de microserviços, um único clique do usuário pode disparar dezenas de chamadas entre serviços. Quando algo fica lento, o problema pode estar em qualquer ponto da cadeia — e sem tracing, você fica refém de suposições.
Imagine um cenário comum: a página de checkout demora 8 segundos para carregar. Sem tracing, o time precisa suspeitar de cada serviço envolvido — gateway, autenticação, catálogo, pagamento, banco de dados — e testar um por um. Com tracing, você abre o waterfall do trace e vê, em segundos, qual serviço consumiu 90% da latência ou qual retornou erro.
O problema deixa de ser um mistério e vira um caminho claro a investigar. É por isso que o tracing é considerado essencial para sistemas distribuídos, que têm problemas não determinísticos e difíceis de reproduzir localmente.
OpenTelemetry: o padrão aberto que unifica tudo
Historicamente, cada ferramenta tinha sua própria SDK e formato de dados — o que travava times em vendor lock-in. O OpenTelemetry resolve isso: é um framework open source que padroniza a geração, coleta e exportação de logs, métricas e traces, com suporte a múltiplas linguagens e backends.
Você instrumenta uma vez com OpenTelemetry e pode enviar os dados para qualquer backend compatível — seja uma solução open source como Prometheus e Grafana, seja um serviço gerenciado. Isso reduz drasticamente o custo de instrumentação e dá liberdade de escolha, além de facilitar a contratação: profissionais já chegam conhecendo o padrão.
Outra vantagem prática é a consistência. Com um padrão único, o time não precisa aprender uma linguagem de instrumentação diferente para cada serviço ou linguagem de programação. A mesma API funciona em Go, Java, Python, Node.js e outras — o que simplifica a adoção em bases de código heterogêneas, tão comuns em empresas que cresceram rápido.
Observabilidade não é sobre ter mais dashboards. É sobre conseguir responder, em minutos, perguntas que antes levavam horas — ou que ninguém conseguia responder.
SRE e SLOs: transformando observabilidade em confiabilidade
Observabilidade não existe por si só — ela alimenta decisões de confiabilidade. É aqui que entram os conceitos de SRE (Site Reliability Engineering): SLI, SLO e alertas baseados em sintomas.
Um SLI (Service Level Indicator) é uma medição do comportamento do serviço do ponto de vista do usuário — por exemplo, a latência de carregamento de uma página. Um SLO (Service Level Objective) é a meta que você define sobre esse indicador, como "99,9% das requisições em menos de 500 ms".
O capítulo sobre monitoramento de sistemas distribuídos do Google SRE Book é leitura obrigatória para quem quer aprofundar nesses princípios. Ele introduz os quatro golden signals — latência, tráfego, erros e saturação — que servem de ponto de partida para qualquer serviço voltado ao usuário.
A regra de ouro é alerter sobre sintomas, não sobre causas. Um alerta de "CPU alta" é barulhento e pouco acionável. Um alerta de "usuários estão vendo erros" é o que realmente importa. Observabilidade bem feita te dá os dados para construir alertas com sinal alto e ruído baixo — evitando o famoso cansaço de alertas que faz times ignorarem páginas importantes.
Como começar: um roteiro prático para o seu time
Adotar observabilidade não precisa ser um projeto de meses. Comece pequeno, com foco em valor rápido:
- Comece pelos quatro golden signals do Google SRE Book: latência, tráfego, erros e saturação. Eles cobrem o essencial de qualquer serviço voltado ao usuário.
- Instrumente com OpenTelemetry desde o início, em vez de adotar SDKs proprietárias. Você evita retrabalho e lock-in.
- Correlacione os três sinais: use o trace ID para ligar logs e métricas à mesma requisição. É isso que transforma dados em contexto.
- Defina SLOs claros a partir dos SLIs que importam para o usuário, e alerte sobre sintomas, não sobre causas.
- Priorize os serviços críticos: comece pelo caminho que mais impacta o usuário (checkout, login, busca) e expanda aos poucos.
- Mensure o impacto: acompanhe o MTTR (tempo médio de resolução) antes e depois. A queda costuma ser o melhor argumento para investir mais.
Não tente instrumentar tudo de uma vez. O objetivo é que, no próximo incidente, o time tenha contexto suficiente para investigar sem adicionar instrumentação na hora — e isso se constrói de forma incremental, serviço por serviço.
Conclusão: enxergar produção é uma decisão estratégica
Observabilidade não é luxo de empresa grande — é o que separa times que apagam incêndio de times que resolvem problemas com método. Logs, métricas e tracing distribuído, unificados pelo OpenTelemetry, transformam incidentes complexos em problemas rastreáveis e resolvíveis.
Se o seu time ainda depende de "olhar o log" na madrugada, talvez seja hora de repensar a estratégia. Na Axus Solutions, ajudamos empresas a desenhar e implementar stacks de observabilidade que realmente funcionam em produção — do desenho da instrumentação à definição de SLOs e alertas.
Quer conversar sobre como aplicar isso no seu contexto? Fale com a gente — vamos mapear juntos o melhor ponto de partida para o seu time.