Inteligência Artificial • 6 min
IA Generativa Aplicada a Produtos Digitais
Modelos de linguagem deixaram de ser um experimento isolado e passaram a integrar fluxos centrais de produtos digitais, desde atendimento ao cliente até geração de código. Para uma software house, dominar essa integração significa entregar produtos mais inteligentes sem depender de equipes gigantes de dados.
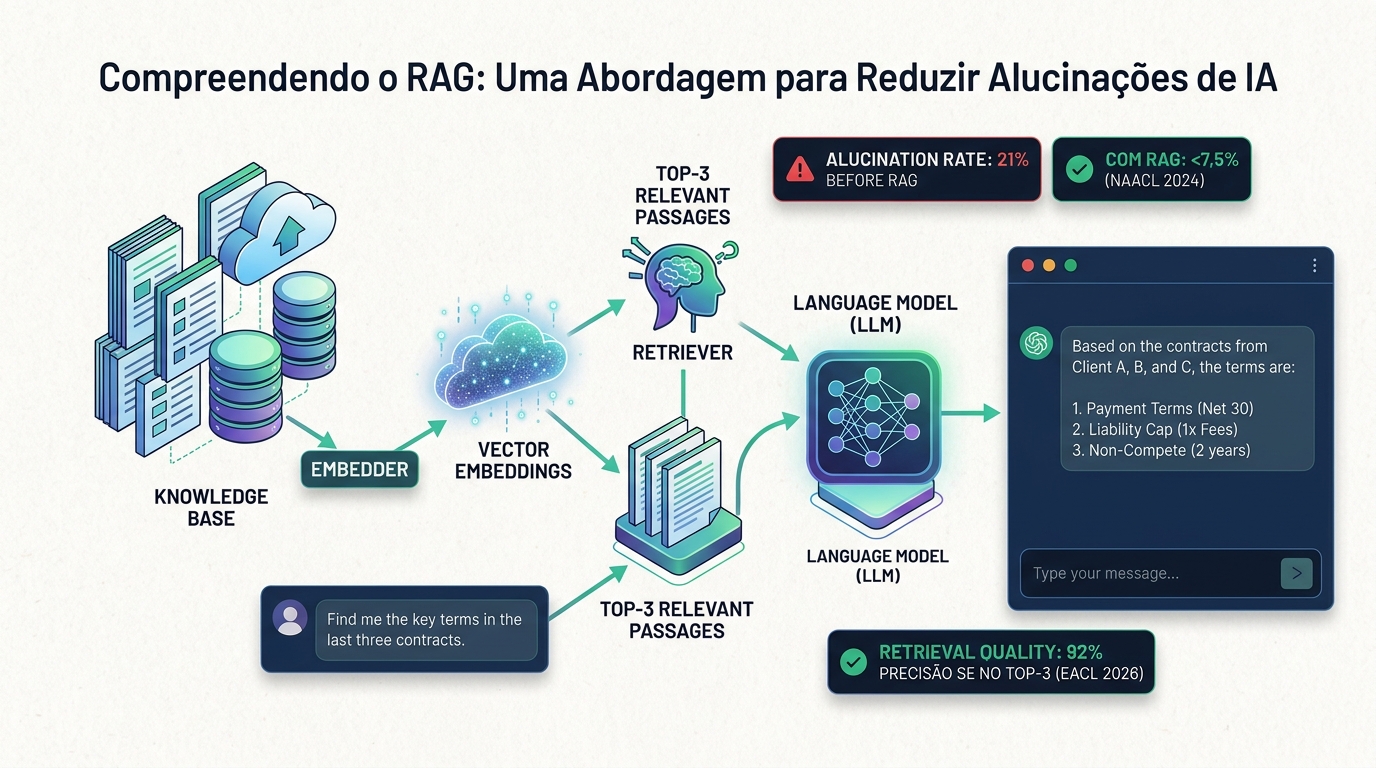
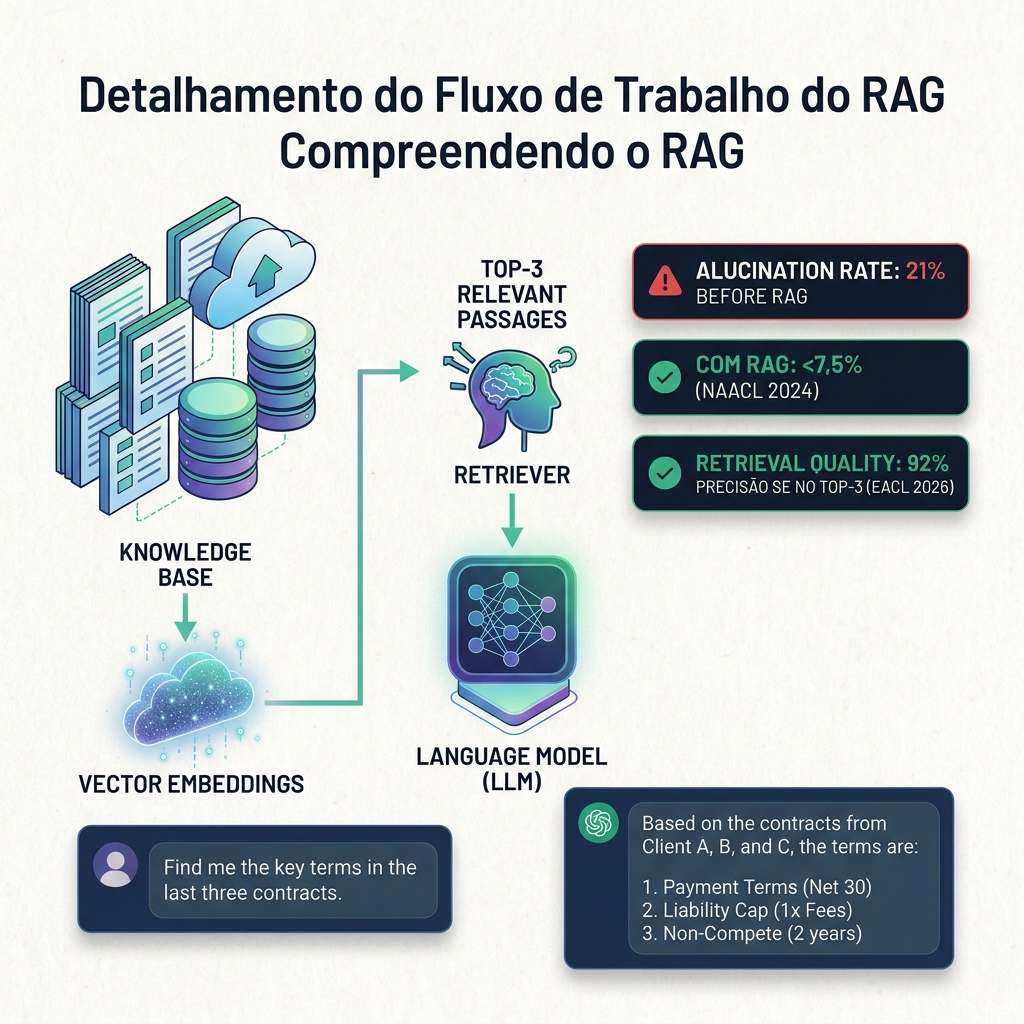
Dado real: um estudo publicado na NAACL 2024 mostrou que a técnica de RAG (Retrieval-Augmented Generation) reduziu a taxa de alucinação de modelos de linguagem de 21% para menos de 7,5% em saídas estruturadas — uma queda de quase dois terços nas respostas incorretas.
IA Generativa: Diferencial ou Modismo?
A adoção de IA generativa só gera valor real quando resolve um problema concreto do usuário. Empresas que implementam essa tecnologia sem um caso de uso claro acabam criando funcionalidades caras e pouco utilizadas.
A revisão técnica publicada no arXiv sobre RAG em aplicações empresariais é direta: a técnica é eficaz para evitar alucinações e imprecisões factuais, porque ancora a resposta do modelo em documentos recuperados de uma base de conhecimento — em vez de depender apenas do que o modelo memorizou durante o treinamento.
Casos de Uso que Funcionam na Prática
Os casos de uso que mais se consolidaram em produtos digitais têm um padrão em comum: envolvem texto estruturado, contexto recuperável e um fluxo claro de validação. Os três mais maduros são:
- Assistentes de suporte e autoatendimento: respondem com base na documentação e no histórico do cliente, reduzindo o volume de tickets repetitivos.
- Geração e revisão de código: completam trechos, explicam código legado e escrevem testes — sempre com revisão humana no fluxo.
- Resumo e extração de informações: condensam contratos, relatórios e e-mails em pontos de ação, economizando horas de leitura.
O que separa esses casos de uso dos que fracassam é a existência de uma base de conhecimento confiável e de um critério objetivo de sucesso. IA sem fonte de verdade e sem métrica é um showroom, não um produto.
1. Engenharia de Prompt como Disciplina
Escrever instruções eficazes para modelos de linguagem se tornou uma habilidade técnica própria, com impacto direto na qualidade, custo e previsibilidade das respostas geradas. Prompts bem estruturados definem papel, contexto, formato de saída e restrições — e isso reduz drasticamente a necessidade de retrabalho.
2. RAG (Retrieval-Augmented Generation)
Combinar modelos de linguagem com bases de conhecimento próprias permite respostas mais precisas e atualizadas, reduzindo o risco de alucinações e mantendo o contexto do negócio. A documentação de casos de uso do Google Cloud descreve o RAG como a abordagem preferida para sistemas que precisam responder com base em informações privadas ou em constante atualização — exatamente o cenário típico de produtos B2B.
Em termos de arquitetura, um sistema RAG tem três componentes: a base de conhecimento (documentos da empresa, transformados em embeddings vetoriais), o retriever (que encontra os trechos mais relevantes para a pergunta) e o modelo de linguagem (que gera a resposta ancorada nesses trechos). A qualidade do resultado depende dos três — e, como mostram os estudos citados, o retriever costuma ser o elo mais fraco e o mais negligenciado.
Um estudo de 2026 apresentado na EACL (conferência europeia de processamento de linguagem natural) reforça o ponto: quando os documentos relevantes estavam entre os três primeiros resultados recuperados, o modelo gerou respostas precisas em 92% dos casos — evidenciando que a qualidade do retrieval é tão importante quanto a qualidade do modelo.
3. Custos e Latência em Escala
Rodar modelos de IA em produção exige decisões cuidadosas sobre quais tarefas realmente precisam de modelos grandes e quais podem ser resolvidas com alternativas mais leves e baratas. O mesmo estudo da NAACL 2024 observa que um retriever pequeno e bem treinado pode reduzir a necessidade de um modelo de linguagem maior — ou seja, a arquitetura certa economiza custo por interação sem sacrificar qualidade.
Na prática, a estratégia mais comum é a rotação por complexidade: tarefas simples (classificação, extração de campos) usam modelos pequenos e baratos, enquanto apenas os fluxos que exigem raciocínio sofisticado acionam modelos maiores. Combinada com cache de respostas para perguntas recorrentes, essa abordagem reduz o custo por interação em ordens de magnitude — e ainda melhora a latência percebida pelo usuário.
Avaliação Contínua: o Que Não Pode Faltar
Produtos com IA generativa não se avaliam apenas com testes unitários tradicionais — porque a saída é probabilística. A prática que se consolidou é manter um conjunto de avaliação (eval set): uma coleção de perguntas com respostas esperadas que cobre os cenários mais importantes do produto. A cada mudança de prompt, de modelo ou de base de conhecimento, o eval set é executado e a taxa de acerto é comparada com a versão anterior.
Essa disciplina transforma a integração de IA em engenharia previsível: você sabe, com números, se uma mudança melhorou ou piorou o produto. Sem ela, cada ajuste é um palpite — e a qualidade do sistema degrada silenciosamente conforme os dados mudam.
Construindo com Responsabilidade
A melhor aplicação de IA é aquela que o usuário nem percebe como IA — ele só percebe que o produto ficou mais fácil de usar.
Empresas que tratam IA generativa como parte da arquitetura do produto, e não como um recurso isolado, constroem experiências mais coesas e conseguem evoluir essas funcionalidades junto com o restante do sistema.
Fatores que Determinam o Sucesso de Produtos com IA
Com base nas evidências dos estudos citados, estes são os fatores que separam produtos de IA que funcionam dos que decepcionam:
- Qualidade dos Dados e do Retrieval: respostas boas dependem de contexto bem estruturado — o retrieval é o que ancora o modelo na realidade do negócio.
- Engenharia de Prompt: instruções claras reduzem erros e custos por interação.
- Latência Aceitável: tempo de resposta impacta diretamente a experiência do usuário e precisa ser medido com SLOs.
- Governança e Segurança: controle sobre dados sensíveis enviados a modelos externos é pré-requisito em ambientes corporativos.
- Custo por Interação: modelos maiores nem sempre justificam o investimento — a arquitetura de retrieval pode reduzir a necessidade de modelos grandes.
Perguntas Frequentes
O que é RAG e quando devo usar?
RAG (Retrieval-Augmented Generation) combina um modelo de linguagem com uma base de conhecimento própria: o sistema busca os trechos relevantes e o modelo gera a resposta ancorada neles. Use quando o produto precisar responder com base em informações privadas, atualizadas ou específicas do negócio.
Como reduzir alucinações em produção?
As evidências apontam para três frentes: melhorar a qualidade do retrieval (os estudos mostram que documentos no top-3 geram respostas precisas em 92% dos casos), manter um eval set para medir regressões e desenhar prompts com restrições claras de formato e escopo.
Modelos grandes são sempre melhores?
Não. O estudo da NAACL 2024 mostrou que um retriever pequeno e bem treinado pode reduzir a necessidade de um modelo maior — o que significa menor custo por interação e menor latência sem sacrificar qualidade.
Conclusão
IA generativa deixa de ser modismo quando é integrada com disciplina: retrieval de qualidade, prompts bem desenhados e controle de custo por interação. As evidências acadêmicas mostram que a combinação de RAG com bases de conhecimento próprias reduz drasticamente alucinações e torna o produto confiável para uso real.
Na Axus Solutions, projetamos produtos com IA generativa desde a arquitetura — com RAG, observabilidade e governança de dados. Se você quer levar IA do piloto para produção com previsibilidade, fale com nosso time.