Engenharia de Dados • 6 min
Pipelines de Dados em Tempo Real
Quando um usuário clica, compra, abandona o carrinho ou reporta um erro, algo acontece no seu produto. A pergunta que separa times de dados maduros dos demais é simples: quanto tempo leva para esse evento se transformar em uma decisão?
Em arquiteturas tradicionais, a resposta costuma ser "horas ou dias" — o dado é acumulado em um data warehouse e processado em lotes noturnos. Para decisões de produto quase instantâneas, esse atraso é inaceitável. É aqui que entram os pipelines de dados em tempo real.
Neste artigo, você vai entender o que é um pipeline de dados em tempo real, por que o streaming de dados virou padrão em produtos modernos e como arquitetar uma solução event-driven com ferramentas como Apache Kafka, Apache Flink e Spark Structured Streaming.
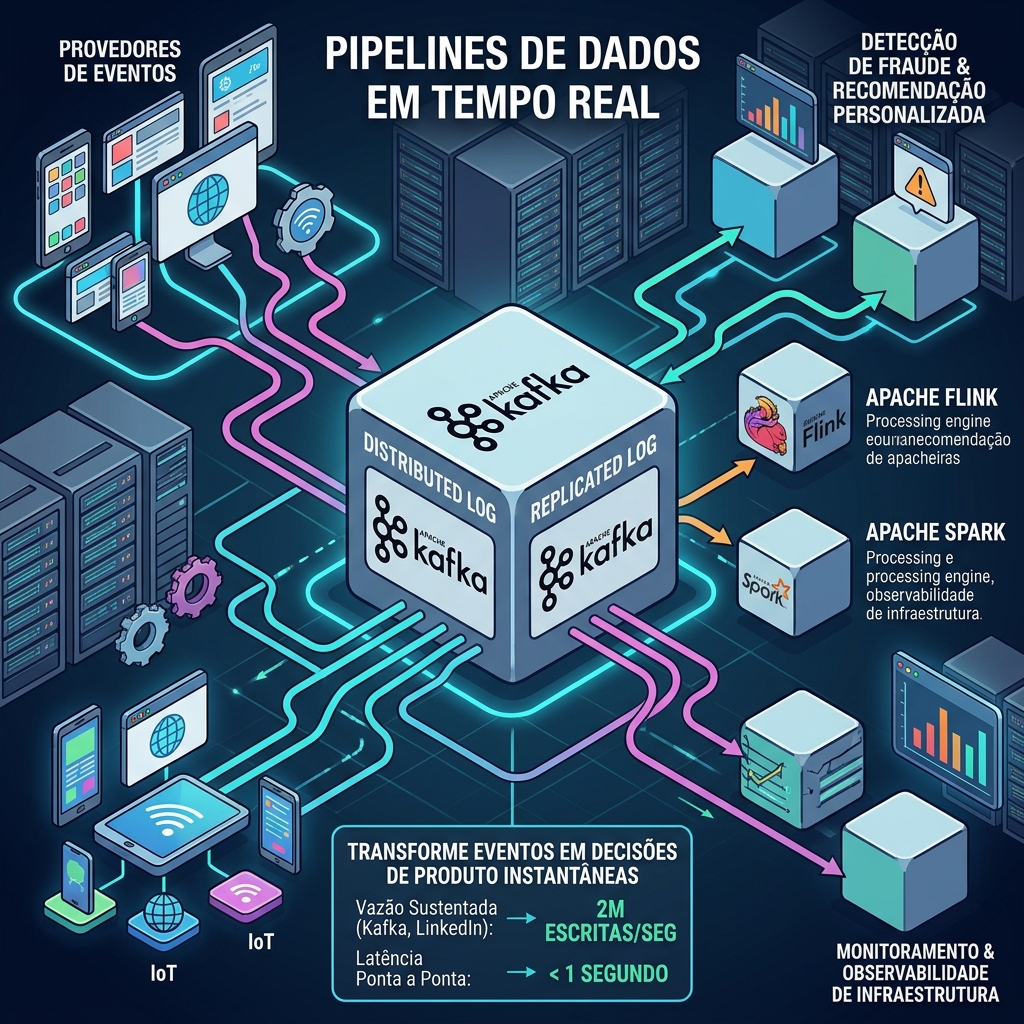
Dado real: em um benchmark publicado pela equipe de engenharia do LinkedIn, um cluster Apache Kafka com apenas três máquinas de hardware modesto sustentou 2 milhões de escritas por segundo — e os clusters de produção da empresa processam dezenas de milhões de leituras e escritas por segundo ao longo do dia. Ou seja: alta vazão em tempo real não exige infraestrutura exótica.
O que é um pipeline de dados em tempo real?
Um pipeline de dados em tempo real é uma arquitetura que captura, processa e entrega eventos no momento em que eles acontecem, com latência de segundos — ou até milissegundos — em vez de esperar por um ciclo de processamento em lote.
A AWS define streaming data como dados emitidos em alto volume, de forma contínua e incremental, que geralmente exigem processamento de baixa latência. São exemplos: leituras de sensores IoT, logs de servidores, eventos de geolocalização e interações de usuários em aplicações.
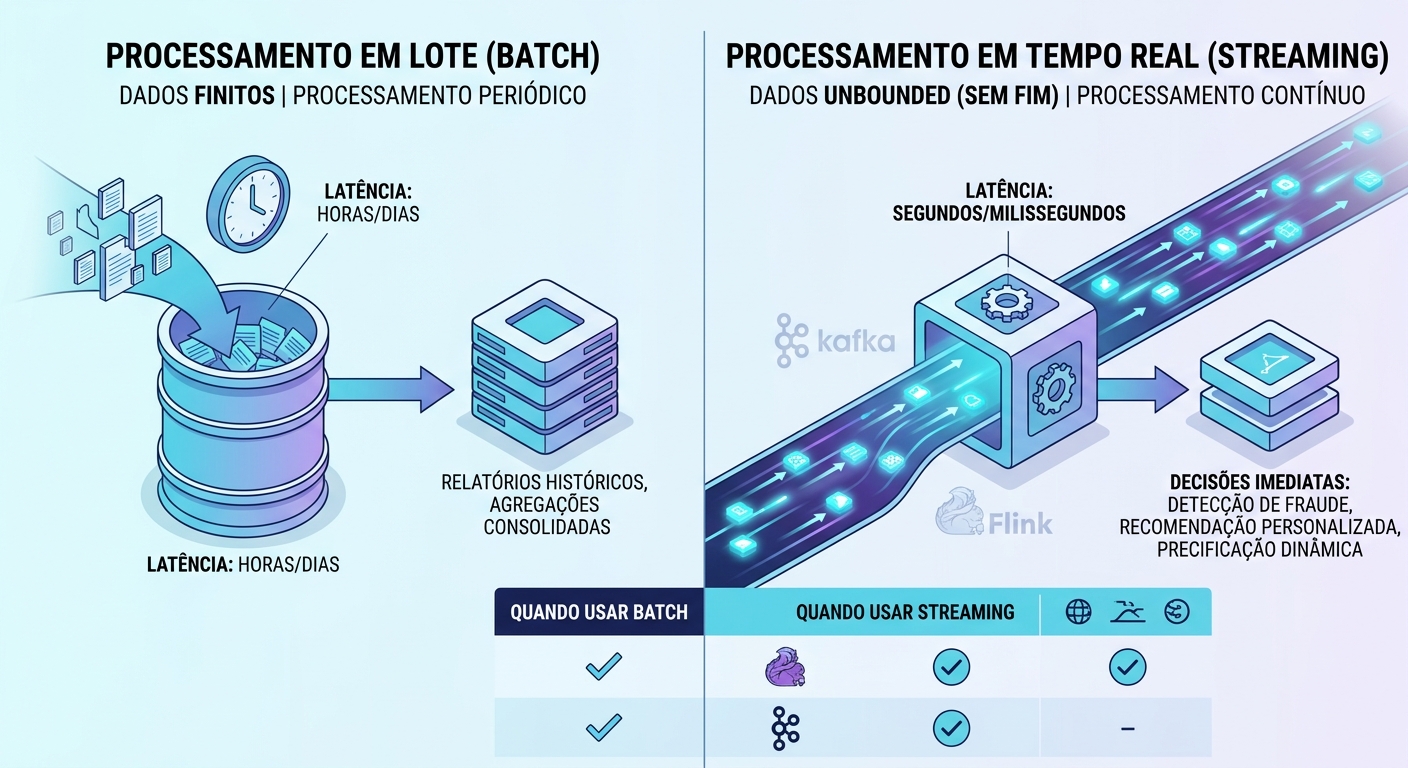
A diferença central em relação ao processamento em lote está na natureza do dado. Em lote, você processa um conjunto finito de dados que já chegou. Em streaming, os dados são "unbounded" — não têm fim definido — e precisam ser processados continuamente, na ordem em que ocorrem.
Por que processar eventos em tempo real?
Decisões de produto quase instantâneas
O maior benefício é a capacidade de reagir no momento. Detecção de fraude, recomendação personalizada, precificação dinâmica e monitoramento de infraestrutura dependem de dados frescos. Um dado que chega tarde demais perde valor.
Arquiteturas event-driven desacopladas
A arquitetura orientada a eventos (event-driven) é o pilar conceitual por trás dos pipelines em tempo real. Como explica Martin Fowler, em sistemas event-driven os componentes se comunicam por eventos em vez de chamadas diretas, o que reduz o acoplamento e aumenta a resiliência e a escalabilidade.
Escala horizontal natural
Como os produtores e consumidores de eventos não dependem uns dos outros, é possível escalar cada parte do pipeline de forma independente — adicionando mais instâncias de consumo conforme a carga cresce, sem derrubar o sistema.
As peças de um pipeline em tempo real
1. Ingestão e transporte: Apache Kafka
O Apache Kafka é o padrão de facto para ingestão e transporte de eventos. Ele funciona como um log distribuído e replicado: produtores publicam registros em tópicos e consumidores assinam esses tópicos.
A documentação oficial do Kafka descreve a plataforma como um sistema de mensageria distribuído, replicado e altamente escalável, usado como hub central de integração de dados. Sua força está em combinar alta vazão com persistência e tolerância a falhas.
Um ponto importante: ao contrário de filas tradicionais, o Kafka retém as mensagens por um período configurável, mesmo depois de lidas. Isso permite reprocessamento, replay de eventos e a reconstrução de estado — recursos essenciais para pipelines confiáveis.
2. Processamento: Apache Flink e Spark Structured Streaming
Depois de ingeridos, os eventos precisam ser processados. Duas opções dominam o cenário:
- Apache Flink é um motor distribuído de processamento de estado sobre streams unbounded e bounded. A documentação do Flink destaca sua capacidade de processar dados em memória, com consistência exactly-once e estado de aplicação de vários terabytes.
- Spark Structured Streaming oferece uma API de streaming sobre o ecossistema Spark, permitindo tratar streams como tabelas e reutilizar o conhecimento de DataFrames.
3. Consumo e ação
O último estágio entrega os resultados processados para aplicações, dashboards ou bancos de dados. É aqui que a decisão de produto acontece: um alerta de fraude, uma recomendação, um ajuste de preço.
Streaming vs. batch: quando usar cada um
Nem todo dado merece um pipeline em tempo real. A escolha entre streaming e processamento em lote deve ser guiada pela latência que o seu caso de uso exige — e pelo custo de operar cada abordagem.
O processamento em lote ainda é a melhor opção para relatórios consolidados, agregações históricas e cargas massivas que não precisam de resposta imediata. Já o streaming brilha quando a ação precisa acontecer perto do momento em que o evento ocorre.
Uma estratégia comum é combinar os dois: usar streaming para as decisões críticas e de baixa latência, e descarregar o histórico para processamento em lote em um data warehouse. Essa abordagem híbrida aproveita o melhor de cada mundo.
Casos de uso reais
Os pipelines em tempo real sustentam produtos que você usa todos os dias:
- Detecção de fraude: analisar transações no momento em que ocorrem para bloquear operações suspeitas.
- Recomendação e personalização: ajustar o conteúdo exibido com base no comportamento recente do usuário.
- Monitoramento e observabilidade: detectar anomalias em infraestrutura antes que virem incidentes.
- IoT e telemetria: reagir a leituras de sensores em fábricas ou frotas.
- Precificação dinâmica: ajustar preços em tempo real conforme oferta e demanda.
"O valor de um evento pode diminuir conforme o tempo passa. Sem a arquitetura certa para capturar e agir sobre eles, esses dados podem rapidamente ficar obsoletos." — IBM, sobre arquitetura orientada a eventos
Boas práticas para arquitetar seu pipeline
Comece pelo dado, não pela ferramenta
Antes de escolher a stack, defina a latência que o seu caso de uso realmente exige. Nem todo dado precisa de streaming — forçar tempo real onde o lote resolve é complexidade desnecessária.
Projete para tolerância a falhas
Streams são contínuos e não terminam. Planeje reprocessamento, retenção de mensagens e consistência exactly-once quando a precisão for crítica.
Monitore o lag dos consumidores
O "consumer lag" — a distância entre o que foi produzido e o que foi consumido — é a métrica mais importante de um pipeline em tempo real. Um lag crescente indica que os consumidores não estão acompanhando a produção.
Evolua o schema com cuidado
Eventos mudam de formato ao longo do tempo. Adote um schema registry e versionamento para não quebrar consumidores quando um campo novo for adicionado.
Checklist prático para começar
- Defina a latência-alvo do seu caso de uso (segundos, milissegundos).
- Escolha a ferramenta de ingestão (Kafka é o padrão) e o motor de processamento (Flink ou Spark).
- Modele os eventos com schema versionado desde o início.
- Configure retenção e reprocessamento para tolerância a falhas.
- Monitore o consumer lag e a latência ponta a ponta.
- Comece pequeno: um único caso de uso de alto valor antes de generalizar.
Conclusão
Pipelines de dados em tempo real deixaram de ser um luxo e viraram um diferencial competitivo para produtos que precisam reagir no momento em que os eventos acontecem. Com streaming de dados, arquiteturas event-driven e ferramentas maduras como Kafka, Flink e Spark, é possível transformar eventos em decisões quase instantâneas — desde que você comece pelo dado e pela latência que o seu negócio realmente exige.
Na Axus Solutions, ajudamos empresas a desenhar e operar pipelines de dados em tempo real, do desenho da arquitetura à operação em produção. Se você quer levar suas decisões de produto para o próximo nível, fale com nosso time de engenharia de dados.